Website-Crawler
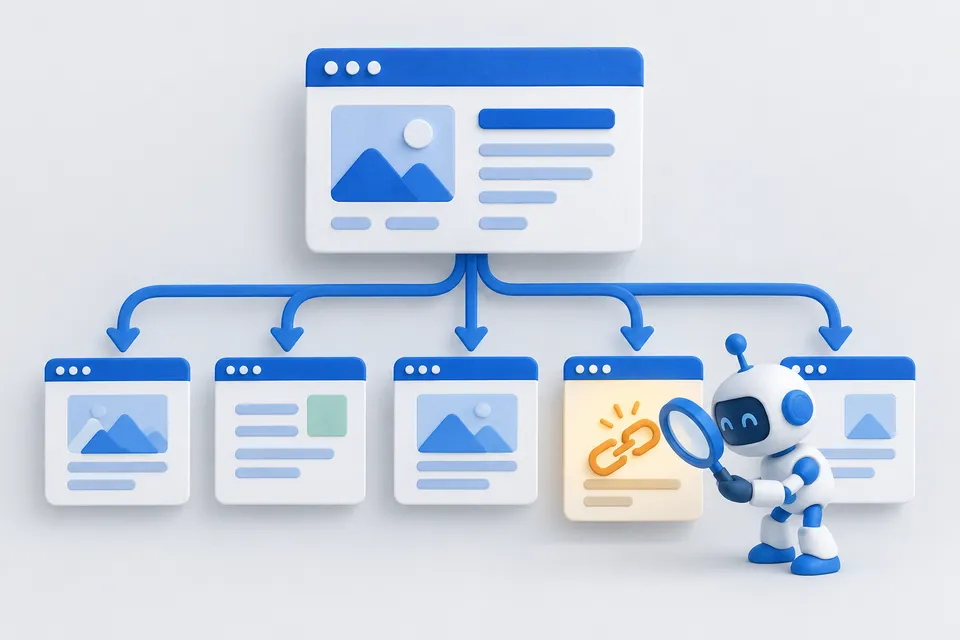
Folgt den internen Links ab der Startseite und prüft jede gefundene Seite. Die robots.txt wird dabei respektiert.
So funktioniert’s
Die Website als Ganzes sehen
- Startadresse und Seitenlimit wählen
- Internen Links folgen lassen
- Probleme zwischen Seiten finden
Startadresse eingeben – der Crawler folgt von dort den internen Links.
Was ein Crawl zeigt, das Einzelprüfungen nicht zeigen
Eine einzelne Seite lässt sich in Ruhe prüfen. Die Probleme, die Sichtbarkeit wirklich kosten, entstehen aber zwischen den Seiten: dieselbe Description auf zwanzig Unterseiten, eine Handvoll toter Links auf gelöschte Angebote, Seiten, auf die kein einziger interner Link mehr zeigt. So etwas sieht man erst, wenn man die Website als Ganzes anschaut.
Der Crawler startet bei der angegebenen Adresse, folgt den internen Links und prüft bis zu hundert Seiten. Fremde Domains werden nicht betreten. Jede Seite wird einmal abgerufen, mit Pause zwischen den Abrufen – ein fremder Server soll davon nichts merken.
Worauf der Bericht hinweist
- Fehlerseiten und Weiterleitungsketten – ein 404 im Menü kostet Besucher, eine Kette aus drei Weiterleitungen kostet Ladezeit und verwässert die Verlinkung.
- Doppelte Titles und Descriptions – der häufigste Befund überhaupt. Google entscheidet dann selbst, welche der Seiten es zeigt, und trifft nicht immer die gewünschte.
- Dünne Seiten – Unterseiten mit ein paar Zeilen Text, die als eigenständige Seite nichts zu sagen haben. Oft besser zusammengelegt als optimiert.
- Verwaiste Seiten – Adressen aus der Sitemap, auf die kein interner Link zeigt. Sie existieren, aber niemand findet sie – Suchmaschinen eingeschlossen.
- Nicht indexierbare Seiten – noindex, Canonical auf eine andere Adresse, robots-Sperre. Manchmal Absicht, manchmal ein Versehen aus der Entwicklungszeit, das nie zurückgenommen wurde.
In welcher Reihenfolge man das abarbeitet
Erst die Fehlerseiten, weil sie Besucher kosten. Dann die Indexierbarkeit, weil eine Seite, die nicht in den Index darf, alles andere überflüssig macht. Dann die Dubletten bei Title und Description, weil sie über den Klick im Suchergebnis entscheiden. Dünne Inhalte zum Schluss – das ist Textarbeit, und die dauert.
Der Bericht lässt sich als CSV herunterladen, um ihn abzuarbeiten und später erneut zu prüfen. Gespeichert wird hier nichts; die Ergebnisseiten sind von der Indexierung ausgenommen.
Weitere Werkzeuge
Aus „Prüfen und vergleichen“ und verwandten Bereichen – kostenlos und ohne Anmeldung.
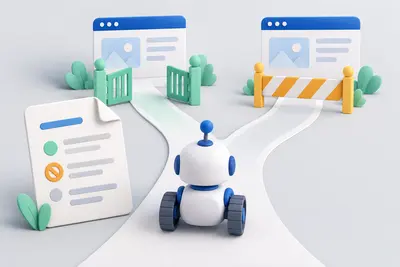
robots.txt testen
Regeln einfügen, Adressen eintragen: Welche Seiten sind gesperrt – und welche Regel greift dabei?
Werkzeug öffnen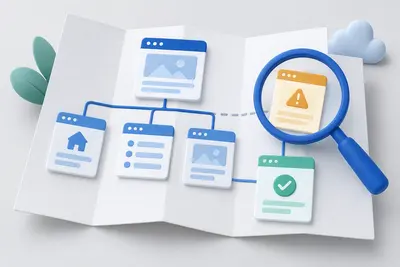
Sitemap prüfen
XML einlesen, Aufbaufehler finden und die enthaltenen Adressen auf Erreichbarkeit testen.
Werkzeug öffnen
URL-Vergleich
Zwei Seiten nebeneinander prüfen – Score, Kennzahlen und jede Einzelprüfung im direkten Gegenüber.
Werkzeug öffnen
Google-Ranking-Check
Wie gut ist eine Seite auf einen Suchbegriff ausgerichtet? Title, Überschriften, Text, Linktexte und die technischen Voraussetzungen.
Werkzeug öffnen
Bild zuschneiden
Ausschnitt wählen, mit festem Seitenverhältnis oder frei – auch mit der Tastatur bedienbar.
Werkzeug öffnen
URL kodieren
Adressen und Parameter kodieren oder lesbar machen, samt Zerlegung in Bestandteile.
Werkzeug öffnen